AI 时代下, 图数据库的时代要来了?

ShawnZhong 2026-03-25 23:03 1
读 一个 Vibe coding 时代的暴论 有感


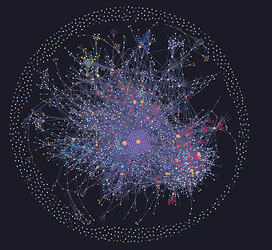
图数据库(Graph Database)


今天认真思考了秦始皇的这篇文章. 我越想越觉得,这才是下一个被严重低估的东西


先说现在的问题


我们现在存数据的方式,本质上还是在用关系型数据库的世界观:万物皆表,关系靠 JOIN.


比如说"A 知道 B,B 又在 C 公司工作,C 公司又在和 D 公司有合作,D 公司的 CEO 曾经又是投资过 A 的竞争对手"这种


五张表(如果参考八大范式来做的话),四个 JOIN,写出来的 SQL 不说长不长, 但是一定很难被抽象出来.


关系型的设计哲学是为了存储数据,而不是为了理解.这在 AI 时代,这虽然不是缺陷 (因为我们还是继续要用), 但是或许我们对于 AI 有更好的选择?


为什么是图数据库?


图数据库(拿 Neo4J 来说)的核心不是"节点",是边(Edge)


这个区别听起来很小,但是在数据库的设计哲学上差了一个量级:


  • 关系型数据库:数据是一等公民,关系是附属

  • 图数据库:关系本身就是一等公民


而且更关键的是,图数据库里的边不是用于索引的外键,它可以带属性——


比如说: A 在 2019 年导师 的身份认识了 B,关系强度 0.87,B 多次挂二作


边不是一个指针,它是一段故事


现在有两件事同时在发生:


第一,LLM 需要结构化的语义基底


现在大家让 AI 做 RAG,往里面塞 chunk,塞向量,本质上还是在喂"文本碎片".但文本碎片是扁平的,它没有告诉 AI 这些碎片之间的关系是什么.


假如说底层是图数据库,AI 不只是在检索相似的文字,它在遍历一张有意义的关系网

推理质量会是两个维度的东西.


第二,Vibe Coding 降低了图数据库的使用门槛


图数据库过去难用,一半原因是查询语言(Cypher、Gremlin)门槛高,另一半是生态不成熟.

Rust 也不是起来了


Rust 在这里能做什么


叠个甲,Python 和 Rust 是我最常使用的语言 , 我很喜欢他们的设计


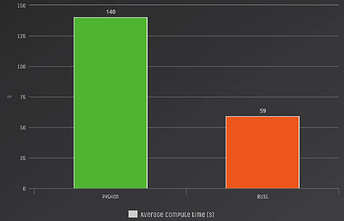
同样的图遍历逻辑,Python 纯实现和 Rust 实现之间的差距不是"快一点",是量级上的差异——有时候是 10x,有时候是 50x,跑大图的时候甚至更夸张


Python 里能跑通的图,放到生产规模就是另一回事


图数据库的核心操作是图遍历——最短路径、子图匹配、社区发现. 这些都是计算密集型任务,而且天然适合并行, Rust 的无畏并发(fearless concurrency)我不是尬吹,是真好用


起个FastAPI , 让 Rust 去扛计算,wc 天作之合.


我真正想说的


把以上所有东西拼在一起,我脑子里有一个画面:

未来的 AI Agent,它的记忆不是一个向量数据库,而是一张图

每一次对话,每一个决策,每一个学到的事实,都作为节点和边写进去.边上有时间戳,有置信度,有来源,有情境

当 Agent 需要推理的时候,它不是在做语义检索,它是在做图上的推理——沿着关系走,发现隐含的路径,推断出没有被明确告诉它的结论


这才是 AI 应该有的记忆方式 : 扁平的、无关系的向量堆砌,说白了是一种将就


或许?


图数据库 + Rust + LLM,会是下一个被重新发现的组合


横看成岭侧成峰,远近高低各不同.

不识庐山真面目,只缘身在此山中.


最新回复 (19)
  • Midsummer 03-25 23:07
    1

    写得好呀,始皇那篇文章我也看了,但是没有你这么深刻的思考

  • ちーちゃん@ていふじょう 03-25 23:09
    3

    GraphQL和graph db没什么关系吧… ^-^

  • l 03-25 23:11
    4

    好高级 ^-^

  • 张六二 03-25 23:14
    5

    字都认识,看不懂

  • ShawnZhong 楼主 03-25 23:15
    6

    GraphQL 和 Neo4J 可以合起来用的

  • groove-88 03-25 23:17
    7

    graphQL和图数据库是两码事。在2023年我们团队就尝试使用图数据库构造业务关系了。用下来后发现大模型不具备垂类业务知识,并且每次更新图数据库的点和边关系需要耗费大量token,性价比不高。那我理解只是相对而言图数据的构造成本降低,但边界并没有拓展。

  • 善解人意屬實有點害羞 03-25 23:17
    8

    確實是 但他滿深刻的 就放過他了

  • 利世りぜ 03-25 23:20
    9

    好高级 ^-^

  • ちーちゃん@ていふじょう 03-25 23:21
    10

    确实是…不vibe coding的话肉眼可见的开发难度很大了 ^-^

  • ShawnZhong 楼主 03-25 23:23
    11

    主要是我司正在考虑重构 Saas 的组织架构系统, 我想牵头做这个事情,所以有了这个念头^-^

  • ShawnZhong 楼主 03-25 23:26
    12

    主要也是看到有人用 obsidian 沉淀个人知识内容

  • linuxdowalle 03-25 23:26
    13

    要火早火了吧,又不是新东西

  • ShawnZhong 楼主 03-25 23:34
    14

    或许佬会是第一个?

  • 废寝忘食 03-25 23:42
    15

    我觉得,传统数据库(或者叫关系型数据库)依旧是绝对的大头,图数据库不可能替代传统数据库。不过我认同 LLM 可能会带来图数据库的发展


    处理非结构化数据是 LLM 的优势,这点无可否认。而非结构化数据也比较适合图结构,能表示可能具有的多样化联系。但是你有没有想过,业务数据真的有这么多非结构化数据吗?比如用户数据,比如某个工厂的台账管理,这些大量的结构化数据才是业务的主流吧。


    此外,就算未来大语言模型的成本持续下降,速度/成本能比得过传统数据库的 CRUD 吗?而且,没必要什么数据都上 LLM 吧,觉得 SQL 麻烦也可以让 LLM 来写嘛

  • ciarany 03-25 23:43
    16

    图数据,不会是知识图谱吧,靠ai提取后还要人工矫正确保图的准确性,很费人力感觉

  • OMO 03-25 23:43
    17

    感觉在把抽象低维的信息用具体高维的形式重构,有点像人类大脑的神经系统,突触、神经元、大脑皮层,难道这就是AI的数据大脑^-^

  • ShawnZhong 楼主 03-25 23:50
    18

    是的,业务的本质是规则,而规则最适合结构化存储

    或许未来大部分业务数据依然留在 SQL 里,只有那些需要推理,关联分析的高价值知识,才会交给图数据库去处理

  • cancaneed 03-26 01:05
    19

    1 如何决定信息放在edge还是node?

    2 怎么抽取信息? 有损or无损? 压缩标准是?

    3 怎么重新把信息组装出来? 需要LLM判断吗?


    请以聊天记录为例说明:

    context={大学羽毛球比赛, A统计学院, B计算机学院}

    A: 你们院的男单挺厉害的

    B: 下午就打完了是吧

    B: 去东门吃烤鱼不

    A: 刚吃完庆功宴

    A: 还得是我们统院大腿, 女单和混双就没输过, 我的作用是没我参加不了比赛[笑]

  • yhok1986 03-26 01:21
    20

    非常有启发!

* 帖子来源Linux.do
返回