gpt-5.5的前端被glm-5.2暴打

七叶怀瑾 2026-06-24 20:43 1
自己在迭代自己的skill,于是向看看标准的效果。

先用的gpt,然后发现不对啊,就算是流口水也不能这么拉吧???

然后切了omp + glm-5.2 果然是gpt的前端太石了 ^-^


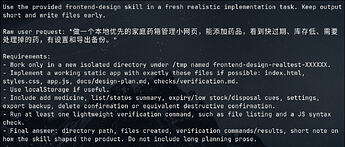
同用frontend-design的skill,

提示词如下:


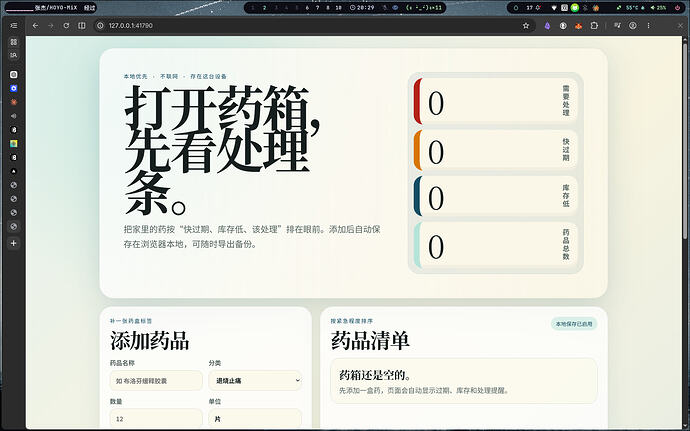
然后这是gpt的


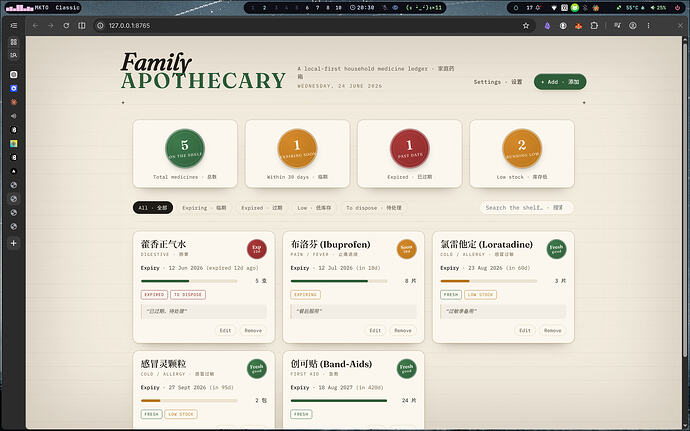
这是glm的


gpt依旧大卡片依旧用前端当readme用 ^-^

glm做的倒是有claude的感觉了嘿嘿 蒸了不少啊(I’m串子

(说实话就算是蒸,蒸出来能让大家都用的起的模型也算是功绩,更何况智谱本身的技术实力也不弱,而且光靠蒸馏可蒸不出这么强的模型来。加油啊glm!

(不过扣套餐可是你一辈子还不完的债哦,不干翻肥波我就不原谅你(傲娇~) 快做啊glm!!! ^-^

最新回复 (19)
  • Eeevan 06-24 20:44
    1

    随便来个200B以上的模型都能吊打GPT的前端吧 ^-^

  • liuliu 06-24 20:44
    2

    感觉不像是glm前端好,而是5.5最近太拉了。像是完全不动脑子的状态。

  • gadfly3173 06-24 20:45
    3

    不要再踹瘸子的断腿了,奥特曼都快站不起来了 ^-^

  • 七叶怀瑾 楼主 06-24 20:46
    4

    gpt不说话,只是一味的大卡片大卡片 ^-^

  • Lavorle10 06-24 20:46
    5

    5.5本来就是前沿大语言模型中做前端最烂的那个啊)

    据奥特曼说5.6可能会有大改进,但只能说到时候再看吧

  • BOOMBOOM 06-24 20:46
    6

    5.5就是不拉的时候前端也是大卡片啊

  • Lavorle10 06-24 20:47
    7

    不降智的5.5也做不好前端,这个已经是很久的问题了)

  • 白芸汐 06-24 20:47
    8

    都是猛踹瘸子那条瘸腿,不过最近5.5降智已经到了写后端也不行了 ^-^

  • 七叶怀瑾 楼主 06-24 20:47
    9

    现在是前端后端都拉了,这两天都流口水

    这pro20用的生不如死

    让他给我的手机app加个ai登录系统,指令清晰,他是硬生生能给我在电脑端弄个后端出来。。。

    我和他说都放手机里面他还来回跟我犟嘴,没招了真是

  • 点点点…点娘! 06-24 20:48
    10

    我是真不知道


    他们这个前端当readme用的习惯是怎么训练出来的


    每次都在模块上扯一大段说明文 ^-^

  • 七叶怀瑾 楼主 06-24 20:49
    11

    真的是,我现在甚至用glm比gpt好用,glm抽象的思维链甚至还能给我繁杂无味的生活添加些许娱乐 ^-^


    现在是前端后端都拉了,这两天都流口水

    这pro20用的生不如死

    让他给我的手机app加个ai登录系统,指令清晰,他是硬生生能给我在电脑端弄个后端出来。。。

    我和他说都放手机里面他还来回跟我犟嘴,没招了真是


  • 七叶怀瑾 楼主 06-24 20:50
    12

    估计是后训练的时候过拟合了,

    前端放一大堆readme,然后评测的模型一看诶不错诶很清晰然后就放行了?

  • kennykinte 06-24 20:50
    13

    这差距有点大啊,怪不得我最近感觉gpt5.5写的代码,各种不如意

  • LeiC 06-24 20:52
    14

    大卡片好啊,有一种流口水的既视感,应用某些场景有奇效 ^-^

  • 七叶怀瑾 楼主 06-24 20:53
    15

    误闯天家给领导展示ai作用的时候(bushi ^-^

  • NoNameSlime 06-24 20:57
    16

    gpt 系列模型就没有一个前端好的……从 5.3codex 时代用到 5.5 时代都是这样

  • Watout 06-24 21:04
    17

    不是说现在codex强制设置思考长度了吗,降智为的都是5.6的厚积薄发 ^-^

  • ulimate057 06-24 21:44
    18

    gpt本来就审美很差再加上最近降智严重更不行了,有人说plus的gpt模型单小时请求数多了会被自动降档到5.4mini。

  • 维维亚米利欧 06-24 22:28
    19

    这是杀浏览器啊?看起来好方便,标签页在左边?

* 帖子来源Linux.do
返回