
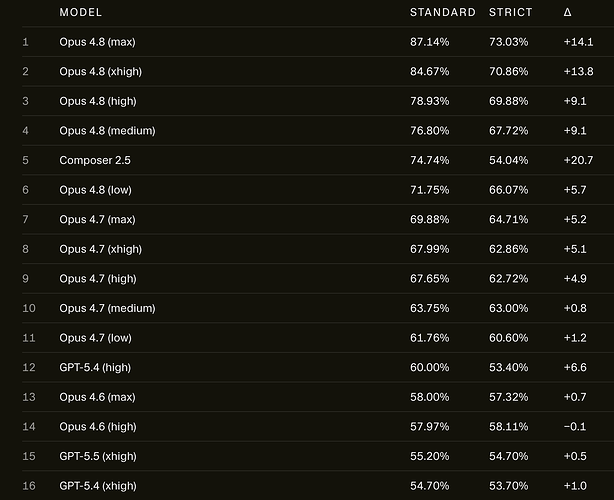
Cursor 团队研究发现opus等模型存在基准测试作弊
Quixotica11y
2026-06-26 19:33
1
最新回复 (2)
-
Quixotica11y 楼主 06-26 19:361楼
-
 ㅤ 06-26 20:022楼
* 帖子来源Linux.do
附近帖子
- ↑Gopay无法订阅GPT plus
- ↑48team续费问题
- ↑新邮箱才注册了3个GPT账号(chatgpt2api),就400了
- ↑慢讯——昨日,IBM 宣布全球首个低于1纳米的芯片
- ↑kiro反代如何放到sub2api
- 📍 Cursor 团队研究发现opus等模型存在基准测试作弊
- ↓大模型应用开发:学习和整理Pi的LLM模块设计
- ↓opencode 坏坏
- ↓佬友如何看待 Mac mini 和 本地部署
- ↓求力推AI工作流最佳 欢迎讨论
- ↓避雷regery.com购买域名
飞读