本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
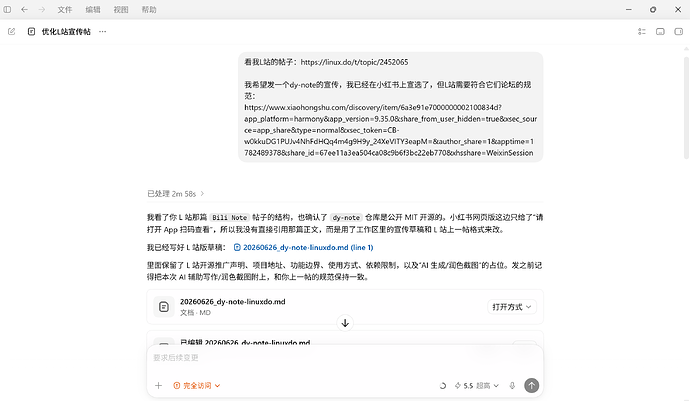
我的帖子已经打上 开源推广 标签:是 我的开源项目完整开源,无未开源部分:是 我的开源项目已链接认可 LINUX DO 社区:是 我帖子内的项目介绍,AI 生成、润色内容部分已截图发出:是 以上选择我承诺是永久有效的,接受社区和佬友监督:是
各位佬友好,之前我发过一个 bili-note,用来把 B 站视频、图文和评论整理成可回查证据的 Markdown 学习笔记。
这次分享一个兄弟项目:dy-note。
项目地址:
GitHub - Rimagination/dy-note: Codex Skill for turning Douyin videos into...
Codex Skill for turning Douyin videos into evidence-based Markdown notes
dy-note 是一个给 Codex / Agent 用的 skill,主要用途是把抖音视频、评论、账号和话题内容整理成本地 Markdown 笔记,并尽量保留原始材料、转写、评论样本、元数据和证据等级,方便后续继续追问、复习,或者放进 Obsidian / 知识库。
它不是把 bili-note 的平台名从 B 站替换成抖音。抖音和 B 站的信息结构不太一样,省 tokens 的方式也不一样。
为什么单独做 DyNote
B 站的视频、图文、评论和字幕结构相对稳定;抖音则更碎,信息经常藏在画面文字、贴纸、商品卡、操作步骤、评论区反馈和账号长期选题里。
很多短视频真正有价值的地方,也不一定是“全文转写”,而是:
这个视频值不值得进一步整理; 评论区暴露了什么需求或误解; 账号的选题结构、开头钩子和栏目节奏是什么; 哪些内容需要原文证据,哪些只需要低成本快读。 如果所有抖音视频都默认下载、转写、总结一遍,token 会被大量消耗在并不值得的地方。
所以 dy-note 的目标不是看到链接就全部跑一遍,而是先判断任务类型,再选择证据足够、成本更低的路线。
它能做什么
整理单条抖音视频,生成学习型 Markdown 笔记; 在有字幕轨或本地 ASR 时,保存转写文本、片段和元数据; 在需要画面理解时,补充关键帧、OCR 或抖音网页里的“问 AI / 识别画面”结果; 分析评论区,提取用户需求、反对意见、FAQ、误解点和真实反馈; 做账号分析,整理选题结构、内容支柱、开头钩子、发布节奏和可复用栏目; 做话题研究、脚本拆解、电商内容分析、竞品观察和知识库归档; 根据材料量、转写密度、评论规模和互动质量生成 note_budget.json,控制笔记应该写多细; 复用已有产物,避免重复问 AI、重复跑 ASR、重复估算预算。 一个比较重要的设计
dy-note 不是固定流程的“抖音总结器”。
它会按任务分层:
quick-pass:适合快速理解、选题筛选、先拿草稿。可以利用页面元数据、抖音网页 AI 或已有摘要,但会标注证据等级,不把快读结果伪装成完整字幕。evidence-pass:适合学习笔记、脚本拆解、引用原文、事实核查。会优先回到字幕轨、本地 ASR、关键帧、OCR 和评论样本。research-pass:适合账号分析、话题研究、竞品观察和批量样本。先低成本收集样本,再决定哪些视频值得升级处理。这样做主要是为了省 tokens,也为了可靠。短视频信息量低时,不硬扩成长文;长视频转写太稀疏时,会提醒可能强依赖画面,不能只靠音频转写写成“完整解析”。
我比较在意的一点是:不同证据有不同用途。
页面简介、抖音问 AI、字幕轨、本地 ASR、关键帧 OCR、评论样本,可信度和适用场景都不一样。dy-note 会尽量把它们分开记录,不把低等级材料写成高等级结论。
比如抖音网页 AI 很适合做快读和章节要点,但它不能直接冒充完整字幕;本地 ASR 能提供文字主干,但它也读不到画面里的贴纸、商品卡和操作步骤。证据不够时,应该先写限制,再决定要不要升级流程。
最终输出
dy-note 的默认目标不是只给一段摘要,而是留下一包后续还能复用的材料。
常见输出会包括:
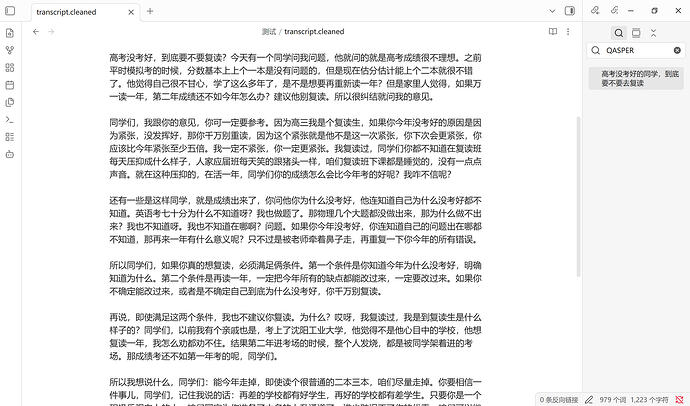
transcript.cleaned.md:适合阅读的转写文本;transcript.txt:纯文本正文;segments.json:片段、时间轴和结构化转写;metadata.json:来源、作者、作品 ID、生成时间等元数据;note_budget.json:根据材料量、转写密度和互动质量估算笔记长度;评论 JSON / CSV:用于评论洞察和需求分析; 关键帧 / OCR:用于画面文字、商品卡、操作步骤等场景; learning_note.md:最终学习笔记。如果这些材料已经存在,它会优先复用。已经有 douyin_ai_brief.json,就不重复问抖音 AI;已经有 transcript.txt、segments.json、metadata.json,就不重复跑 ASR;已经算过 note_budget.json,就不重复估算预算。
使用方式
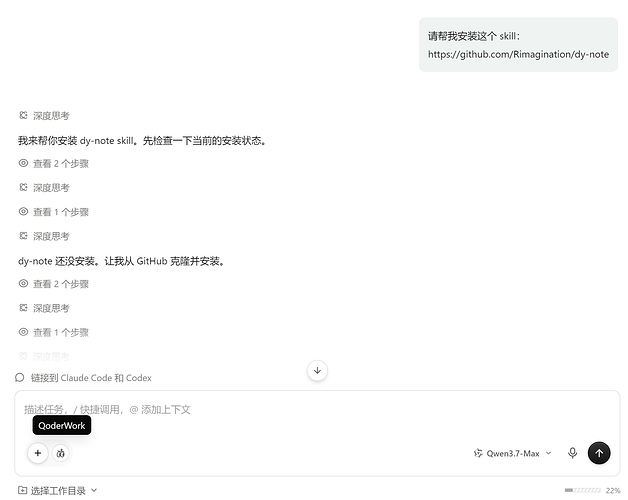
在 Codex 里安装:
请帮我安装这个 skill:用国产的 QoderWork 也可以:
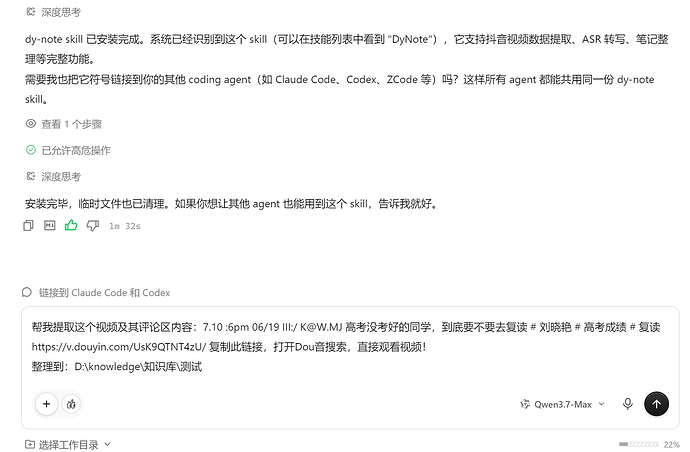
整理单条视频:
请用 dy-note 整理这个抖音视频:
如果只是想快速判断值不值得深挖:
请先低成本快读这个抖音视频,告诉我它值不值得做完整笔记。如果想连评论区一起看:
请分析这个抖音视频和评论区,整理用户需求、反对意见和 FAQ。如果想做账号或话题研究:
请用 dy-note 分析这个抖音账号的内容结构和可复用选题。把结果导入Obsidian更直观,可以看到所有字幕都整理出来了:
依赖和限制
抖音很多视频没有稳定可抓取的独立字幕,必要时需要本地 ASR。 中文视频默认更适合复用 Qwen3-ASR 环境,必要时也可以走 Whisper 系后端。 画面里的贴纸文字、商品卡、操作步骤等,不能只靠音频转写,需要关键帧、OCR 或抖音网页 AI 辅助。 抖音网页 AI、评论抓取、账号页面等场景通常需要使用当前已登录的浏览器环境。 项目不会要求导出 Cookie、token 或本地登录凭据,也不应该把这些信息写进日志或文档。 适合谁
如果你经常在抖音刷到教程、经验分享、工具推荐、产品观察、账号拆解或行业判断,并且希望把它们沉淀进 Obsidian、知识库或长期资料库,dy-note 应该会比较有用。
它和 bili-note 的关系大概是:
bili-note 更适合 B 站长视频、课程、技术教程、图文动态和评论归档;dy-note 更适合抖音短视频、评论洞察、账号分析、话题研究和低成本筛选。两个项目也会复用一部分本地能力,比如 ASR 环境和缓存。已经装过其中一个,再用另一个时可以少折腾一点。
项目地址:
dy-note: GitHub - Rimagination/dy-note: Codex Skill for turning Douyin videos into evidence-based Markdown notes · GitHubbili-note: GitHub - Rimagination/bili-note: Extract Bilibili videos into learning-oriented Markdown notes with full subtitle and comment archives · GitHub欢迎佬友试用、提 issue,也欢迎直接改。这个项目还会继续迭代,尤其是评论洞察、账号分析和证据分层这几块。
最后,附上我在 Codex里的生成 / 润色截图:

 梨涡近点ಣ 06-27 14:121楼
 dfeiwej 06-27 14:302楼