今年开始,我都在高强度的写作,但一直没有把这些文章做成体系,前两天我看到有人用 WorkBuddy + ima 搞了一个知识库,做的非常不错,直接让我激动了,于是就有了这篇干货教程。
这篇从 0 开始带大家使用 WorkBuddy + ima 来把本地知识库搭建起来。
首先,在 WorkBuddy 连接器中找到 ima 这个连接器。
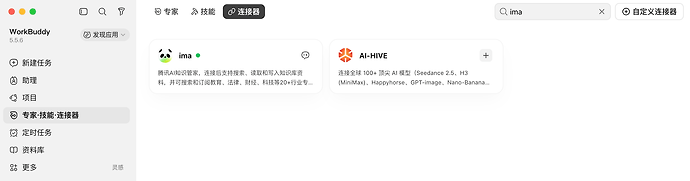
然后点击连接授权,用微信登录一下就可以了。
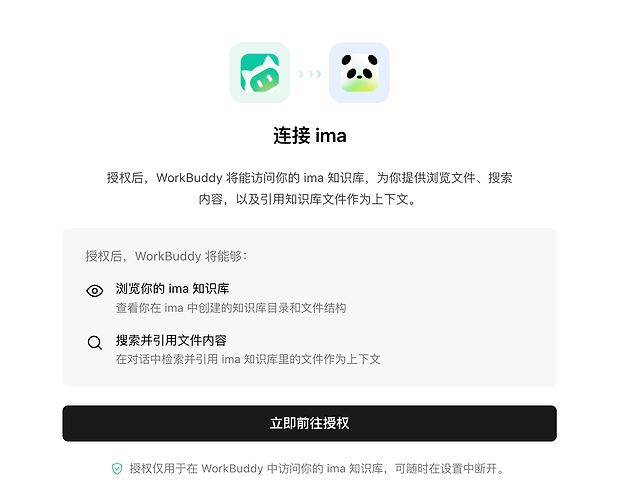
授权登录完成后会来到知识库主页,此时只有一个默认的知识库,还没有文档和教程。
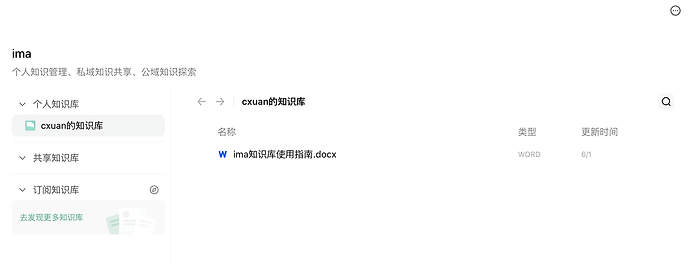
知识库这块分为三类,个人知识库,共享知识库和订阅知识库。
个人知识库是我用得最多的一个,因为我写的文章和攒的资料全在里面。
如果你暂时不知道有哪些知识库可用的话,可以用一下订阅知识库。订阅知识库相当于是一个知识库广场,里面儿啥都有。
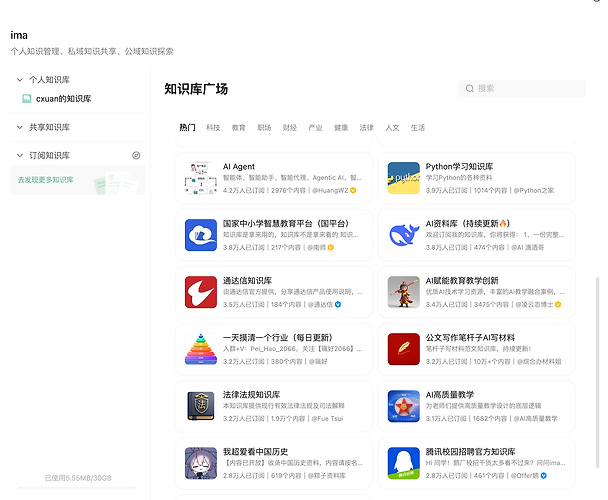
我刚点进广场的时候也愣了一下:里面是按"热门、科技、教育、职场、财经、产业、健康、法律、人文、生活"分的,每个库都标着订阅人数和条目数。比如排在前面的《AI Agent》有 4.2 万人订阅、2976 个内容,《Python 学习知识库》3.9 万人订阅,还有一个《公文写作笔杆子AI写材料》,条目数直接是 10 万加。
也就是说,你还没开始攒的时候,就已经有一堆别人攒好的库可以先订阅着用。
这三类不是按内容分的,是按谁能看见来区分的。我一开始以为它们是三种不同的资料类型,搞了半天才发现说的是权限。
类型 |
谁能看见 |
用来干嘛 |
|---|
个人知识库 |
只有自己 |
自己攒自己的资料,只有自己有写入权限 |
共享知识库 |
团队内部 |
成员各写各的、互相能查,适合把团队资料沉淀到一处 |
订阅知识库 |
广场上所有人 |
去广场订阅别人的库,人家更新你也能看到 |
这样就把知识库接入了,然后在 WorkBuddy 中把它启用一下就行了。
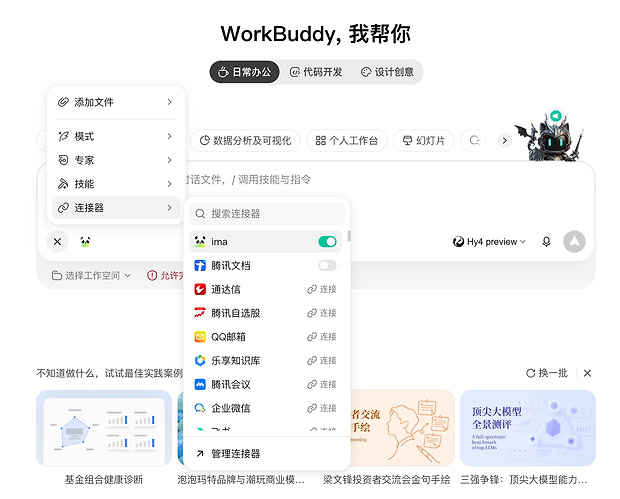
我们可以问他一个简单任务:
列出我已有的知识库都有哪些
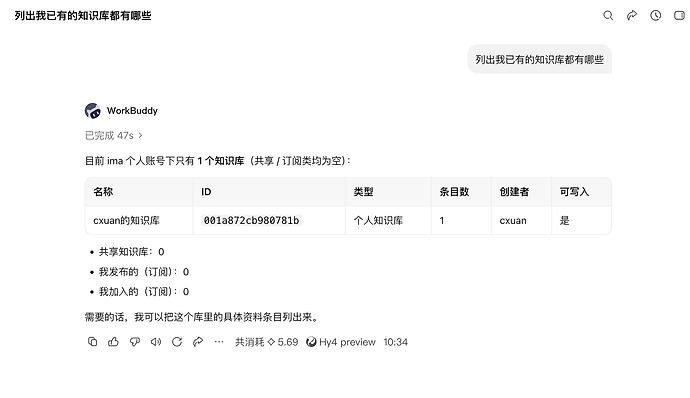
呃,因为我们刚接好知识库,还没开始玩起来,所以只有一个。
下面我就带着大家把知识库来玩起来!
这里可以下载一下 ima 知识库的桌面端和手机端,可以随时随地使用知识库,并且把存储空间扩容。
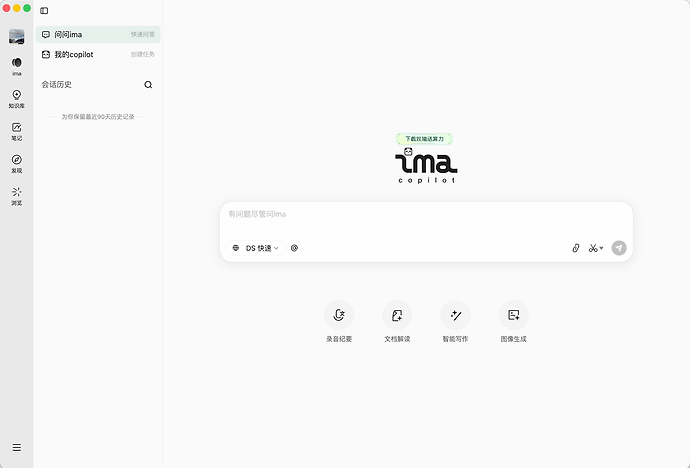
为了给大家演示清楚,我索性直接把自己的文章作为案例了。
上传知识库的方式有很多种,可以从本地上传,直接甩个 url ,从微信上传,还可以导入笔记以及录音等。
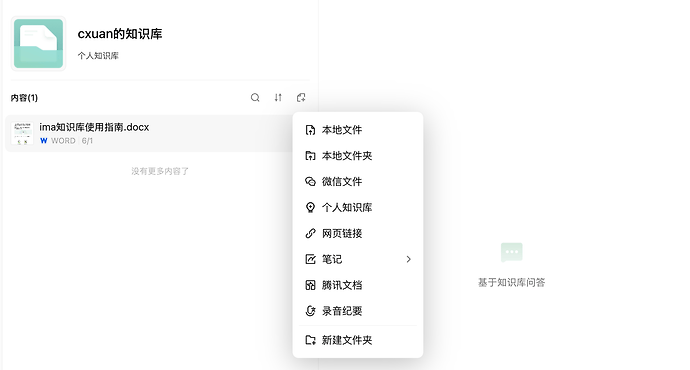
于是我把我全部的文章都上传了。
除此之外,我觉得还有一个比较丝滑好用的上传方式是微信文件,我很多消息来源都是各种微信群,如果你看到别人分享不错的资源,可以通过微信文件上传的方式来上传到知识库中。
这种方式会打开一个 ima 小程序,然后选择群聊进行文件上传。
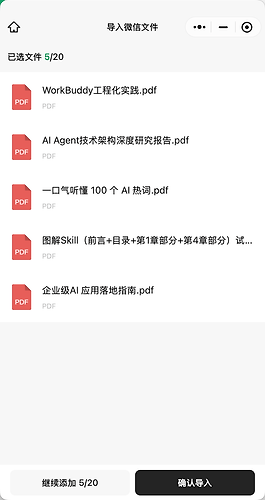
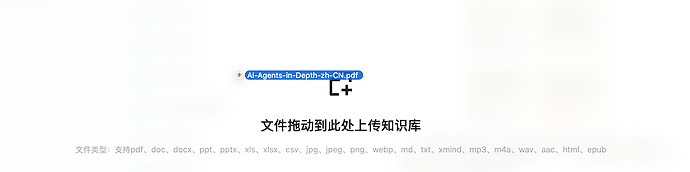
也可以支持直接把文件拖动放到 ima 知识库中,上传方式这块基本上是全覆盖了。
我把我的资源都上传之后,不看不知道,一看吓一跳,一共 257 篇内容。。。所以以我这个输出频率来看,基本上是一天一更或者一天两更,更有的时候一天三更了。。。
我们先让 WorkBuddy 分析一下我写过的文章都包含了哪些内容。
看一下 cxuan 的知识库里面都包括哪些类型的文章。
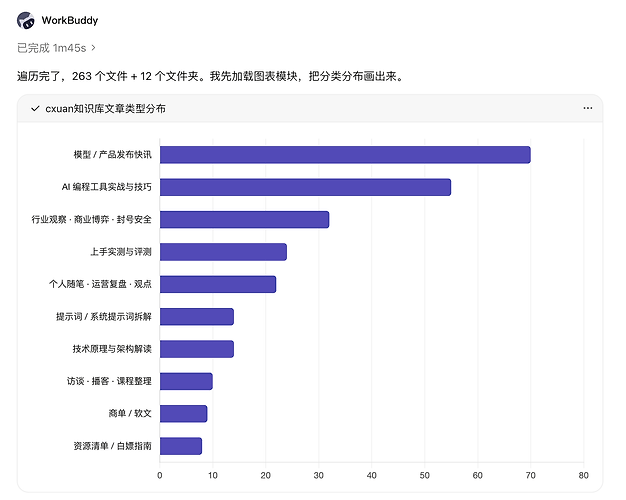
如果说再具体一点的文章类型,大概是下面这些。
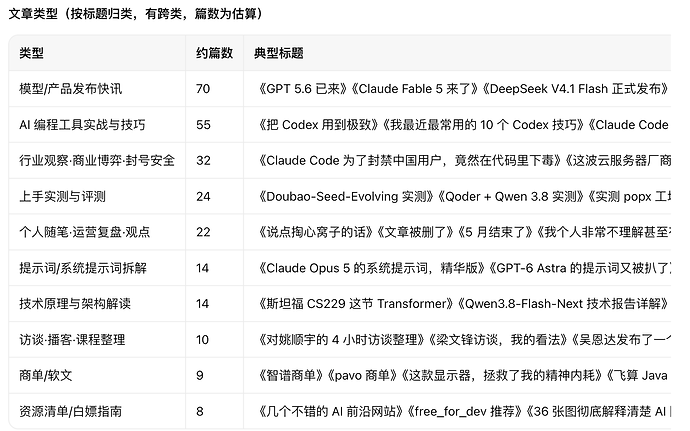
从下到具体资料总结,从上到行业观察,从 0 到 1 系列,源码分析系列,资源分享系列,AI 实战系列,实测系列。。。。。。没想到写了这么多类型。
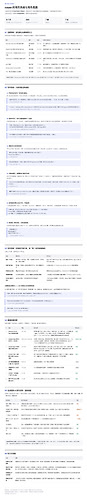
下面我可以让 WorkBuddy 列举一下我的写作风格和写作思路,然后让它列出最硬核的几篇,然后做一个报表给我。
cxuan 的写作风格和写作思路是什么,列出你觉得写得最硬核的几篇内容,然后绘制出一张报表
WorkBuddy 给我绘制了一张长图(点开可以看大图)
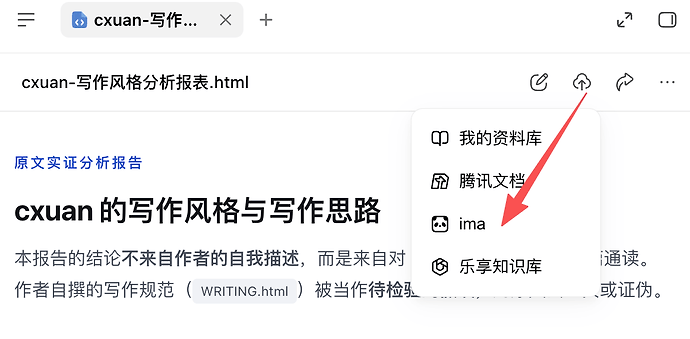
就连这个写作分析的报表,也可以上传至知识库中。
还可以这么用,比如我不知道从今年年初到现在都发布了哪些模型,我想让 WorkBuddy 梳理一张模型发展图出来。
PS:这是以我写过的模型发展为基准,不是互联网上所有的模型。
请你根据我知识库中提到的模型,来梳理一份年初到现在的模型发布鱼骨图
我去,WorkBuddy 给我整理出来的这份报表也太详细了,我都不知道这半年多以来都有这么多模型大事件。
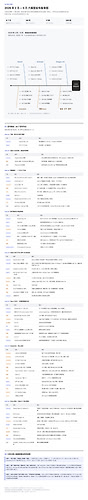
它的做法是以时间为脊椎、厂商为肋骨,而且自己立了个规矩,所有节点都必须能回溯到对应月份的原文归档,没在知识库里出现过的发布不入图。
OK ,现在 WorkBuddy 已经足够了解我了,现在我想学习一本书,我想基于我目前的知识水平,来让 WorkBuddy 评估这本书接下来我需要学习的重点是什么,这是我觉得知识库最有价值的场景之一。
我先让 WorkBuddy 查一下我的知识库里面有没有这本书
查一下知识库里面有没有 AI Agent 系统性学习的书籍?
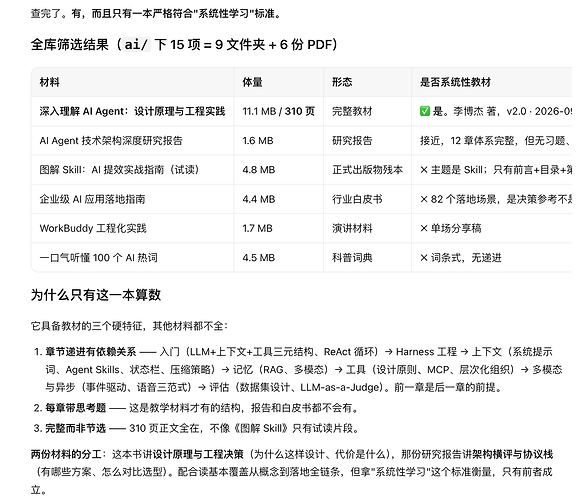
它把 ai/ 目录下的 15 项材料全筛了一遍(9 个文件夹 + 6 份 PDF),最后只认了一本:《深入理解 AI Agent:设计原理与工程实践》。而且它给了三个硬标准:章节递进有依赖关系、每章带思考题、完整而非节选。我那几份研究报告、白皮书、演讲材料、科普词典,要么没有习题结构,要么只有试读片段,所以全被排除了。
下面这个 prompt 我认为是知识库最有价值的体现了
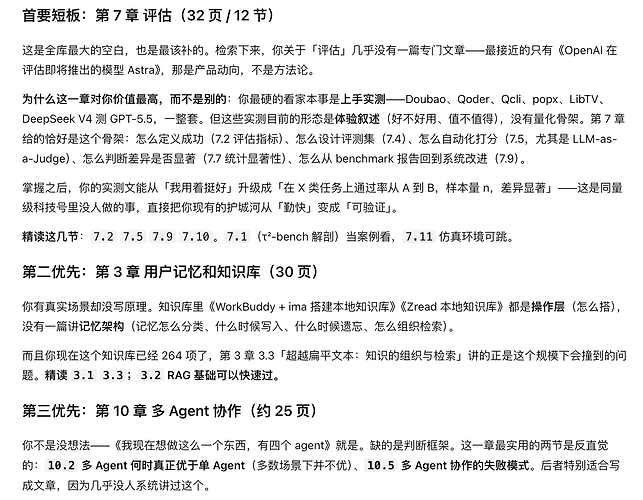
基于我已有写作内容的知识量,再以这本书为基线,你觉得我首要应该提升的地方在哪里,我最应该读哪几章的内容?
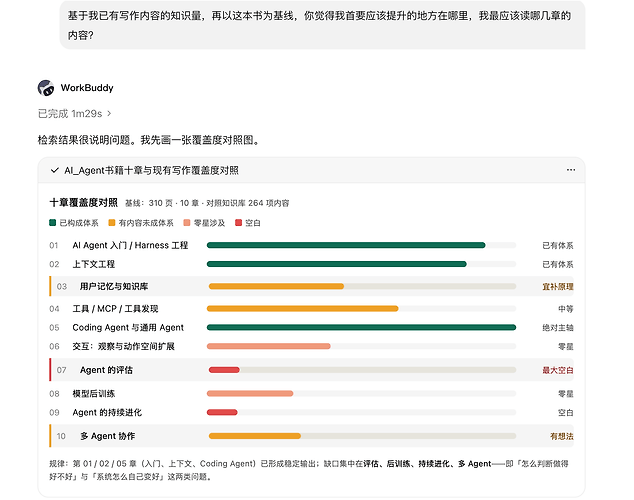
结果出来了,WorkBuddy 认为我最应该提升的是
还有邪修用法,很多朋友不都有收藏癖么,你可以把网上搞到的资源直接扔到知识库中,然后写个定时任务,定时检索你都扔进去什么东西,写个系统性的清单出来,比单纯点个收藏有用多了。
我自己是这么干的:
每周一早上,检索我知识库里上周新入库的内容,按主题归类,

输出一份清单:这周我存了什么、分别是什么类型、哪些还没看过、哪些值得整理成文章。
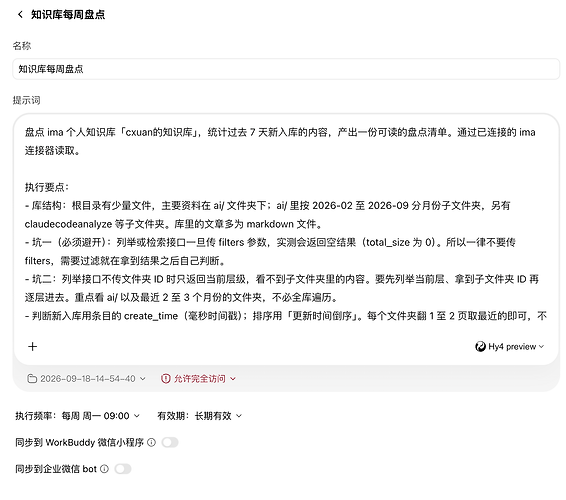
区别在这儿:收藏只是把东西从别人的网页挪进你的收藏夹,东西还是那些东西;入库加定期检索,是让 WorkBuddy 替你读一遍,然后告诉你你存了什么。前者是囤积,后者才算复盘。
整个用了一圈下来,WorkBuddy + ima 的体验非常不错,我觉得这才是 AI 时代的最佳知识引擎。

 高启兰 09-19 21:331楼
 相趣 09-19 21:362楼
 黑猫警长 09-19 21:443楼
 bigtoken 09-19 21:484楼
 kkwin 09-19 21:495楼
 ://a🐱🐉 09-19 21:586楼
 lmy679 09-19 21:597楼
 (ps:无恶意,单纯问问)