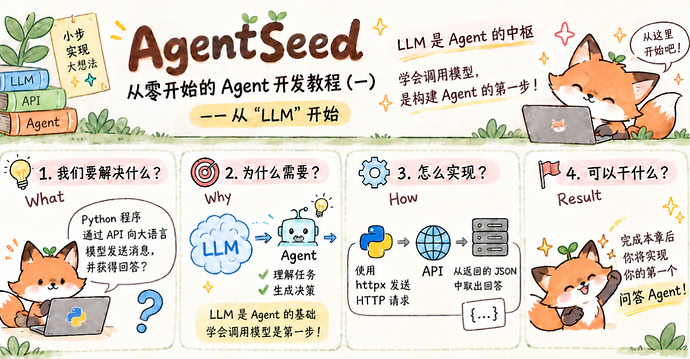
(本系列项目的出发点是记录Agent内核开发的一点点心得并进行小小的知识分享,顺便帮助自己查漏补缺&巩固知识,所以可能会有错漏或者分歧,希望可以跟佬友们一起学习共同进步)
(现在项目还比较前期,虽然在开发Agent的过程中积累了一定的经验以及感受,不过可能还需要进一步转化后再分享出来,好吧其实就是可能会拖稿orz,疯狂叠甲 过!)
一、在开始写代码前:我们是怎样使用 AI 的?
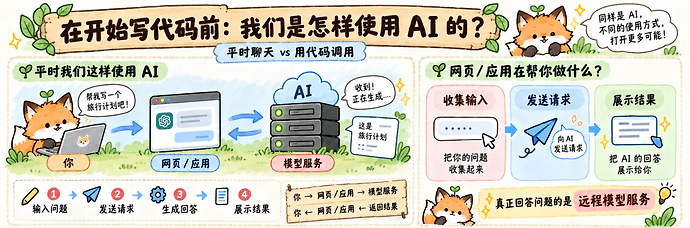
我们先回顾一下平时使用 AI 的方式。
最常见的方式是打开一个网页或桌面应用,在输入框中写下问题,点击发送,然后等待模型返回答案。这个过程看起来很简单,但背后其实已经完成了几件事情:
- 客户端收集了我们输入的消息;
- 客户端把消息发送给模型服务;
- 模型服务根据消息生成回答;
- 客户端接收回答,并把它展示在页面上。
网页或桌面应用只是替我们完成了“收集输入、发送请求、展示结果”这些工作。真正负责理解问题和生成回答的,仍然是远程模型服务。
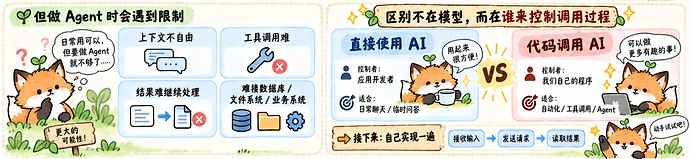
这种方式非常适合日常使用,但当我们想构建自己的 Agent 时,就会遇到一些限制:
- 我们无法自由决定请求中携带哪些上下文;
- 很难让模型按照自己的程序逻辑调用工具或执行任务;
- 模型的回答停留在页面里,不能直接被 Python 程序继续处理;
- 我们无法方便地把模型接入自己的数据库、文件系统或业务系统。
因此,使用 AI 和 用代码调用 AI 的区别,并不在于使用了不同的模型,而在于谁来控制模型调用过程,直接使用AI相当于开发者预先制定了受限的功能,而代码调用则可以根据自己的需求做到更灵活的“个性化定制”:
接下来我们要做的,就是把网页应用隐藏起来的过程自己实现一遍:
用 Python 接收用户输入,向模型服务发送请求,再读取并处理模型返回的结果。
这样,模型就不再只是一个聊天窗口里的工具,而会成为我们程序中的一个基本模块。
二、Agent原型机
尽管现在Agent功能五花八门,但是Agent最本质的能力就是接受用户输入,然后根据用户的输入进行回答或者是操作,因此我们这一节的目的就是构建这样的问答交互——“Agent原型机”:
[center]
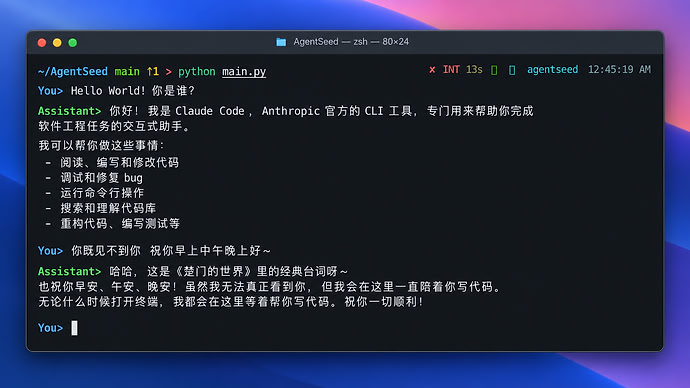
为了实现这种循环对话的Agent,我们只需要做两件事:
- 配置环境变量用于访问模型服务。
- 向模型发送请求并解析结果。
首先我们将项目克隆下来,并切换到第一个版本 v0.1-llm-api-call:
git clone https://github.com/Nick-Hogo/AgentSeed.git

cd AgentSeed

git switch --detach v0.1-llm-api-call
下面是项目v0.1原型机的全部代码,现在看不懂也没关系,后面会慢慢解释:
import httpx


# 获取模型服务地址、访问密钥和模型名称。

base_url = "https://api.example.com/v1/messages"

api_key = "sk-xxxx"

model = "kimi-k3"


while True: # 持续接收用户输入,实现最基础的命令行对话。

    user_input = input("You> ")


    # 按照 Anthropic Messages API 协议向模型服务发送 HTTP 请求。

    response = httpx.post(

        base_url,

        headers={

            "x-api-key": api_key, # Anthropic 格式的认证信息

            "anthropic-version": "2023-06-01", # Anthropic API 版本

        },

        json={

            "model": model, # 选择的模型名称

            "messages": [

                {"role": "user", "content": user_input}, # 用户输入的消息

            ],

        },

        timeout=60,

    )


    # 将 JSON 响应转换为字典,然后取出模型生成的文本。

    data = response.json()

    assistant_message = data["content"][0] # assistant 角色表示模型回复

    print("Assistant>", assistant_message["text"])
三、参数解析
为了能顺利将上面的代码跑起来,我们首先需要准备一些东西:
参数 |
说明 |
示例 |
|---|
base_url |
模型服务的地址 |
https://api.example.com/v1/messages |
api_key |
访问模型服务的密钥 |
sk-xxxx |
model |
使用的模型名称 |
claude-5-fable |
这是因为由于我们没有本地部署LLM的能力,因此我们需 要向厂商购买LLM的使用权限。
而 base_url、api_key、model这三个参数,则分别用来标识我们的 服务商、消费凭证、消费对象。
补充说明一:现在主流的LLM API调用主要有几种不同的通讯格式。 这里我们选择以v1/messages结尾的anthropic格式,因为相较Openai的格式Anthropic相对稳定且被广泛使用。
补充说明二:如果没有购买过Coding Plan的朋友,可以查看下面项目,可能有免费的试用Plan,找到适合自己的Coding Plan就好。
四、代码解析
设置好参数基本就已经 解决 80% 的困难了!
剩下只要理解理解代码逻辑就好了~
首先我们可以看到 while True,这是多轮对话开始的标志,意味着程序将持续不断的接受用户的输入并给出回复。
同时这也是后续我们的Agent Loop的雏形。我们可以根据自己的喜好设置终止条件 例如 检测到特定字符串(exit)。
然后就是相对陌生的一个函数调用 httpx.post,要理解这个我们的先知道:
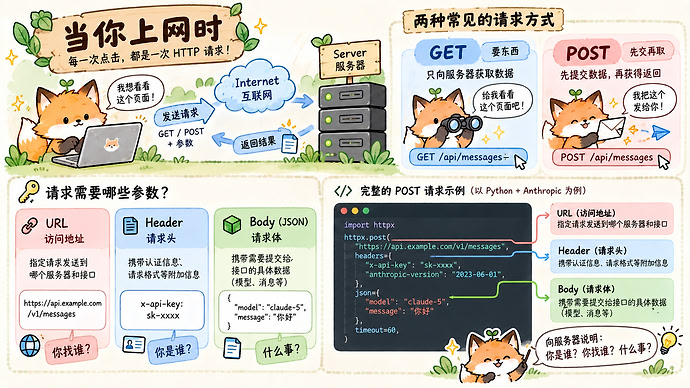
我们每天冲浪的时候,底层实际上就是不断在跟服务器发送请求,请求的形式主要有2种POST以及GET,分别代表单纯向服务器要东西(GET),以及先向服务器提交东西再获得返回(POST)
这里由于我们需要将用户的输入,提交给服务器,然后再从服务器获得返回,因此我们选择了POST。
发送请求的时候,我们需要携带服务器需要的参数,访问地址(url),请求头(header), 请求体(json)…
他们的作用以及对应关系是 :
参数 |
英文名称 |
作用 |
示例 |
|---|
访问地址 |
URL(默认第一个参数) |
指定请求发送到哪个服务器和接口 |
https://api.example.com/v1/messages |
请求头 |
Header |
携带认证信息、请求格式等附加信息 |
x-api-key: sk-xxxx |
请求体 |
Body(JSON) |
携带需要提交给接口的具体数据 |
{“model”: “claude-5.”, “message”: “你好”} |
向服务器发送请求,其实跟门卫大爷问话类似,你需要回答:
你是谁?(请求头)
你找谁?(访问地址)
什么事?(请求体)
都通过了之后,就可以获得服务器响应的内容了。
不同消息格式略有差异,我们以 Anthropic Messages API 格式为例(通常url以v1/messages结尾)。
除了模型生成的文本,服务器通常还会返回模型名称、结束原因以及 Token 用量等信息。下面是简化后的响应,仅保留初学阶段需要关注的字段,省略思考块等内容:
{

  "model": "claude-fable-5",

  "type": "message",

  "role": "assistant",

  "content": [

    {

      "type": "text",

      "text": "Hi! How can I help you today?"

    }

  ],

  "stop_reason": "end_turn",

  "usage": {

    "input_tokens": 32,

    "output_tokens": 39

  }

}
其中常用字段的含义如下:
字段 |
作用 |
示例 |
|---|
model |
服务返回的模型标识 |
claude-fable-5 |
type |
返回对象的类型 |
message |
role |
消息发送者的角色,assistant 表示模型回复 |
assistant |
content |
模型返回的内容块列表 |
遍历列表,读取文本块 |
content[].type |
当前内容块的类型 |
text 表示文本,thinking 表示思考 |
content[].text |
文本块中的回答正文 |
Hi! How can I help you today? |
stop_reason |
模型停止生成的原因,end_turn 表示本轮回复结束 |
end_turn |
usage.input_tokens |
输入内容消耗的 Token 数量 |
32 |
usage.output_tokens |
输出消耗的 Token 数量,可能包含思考用量 |
39 |
这里的模型标识沿用服务商返回值,具体可用模型以实际服务商为准。
[center]
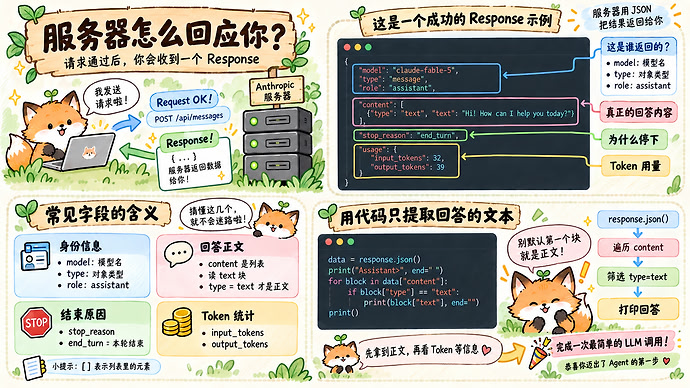
我们主要关心模型最终回复的文本。实际响应的 content 还可能包含 thinking 等内容块,第一个块不一定是正文,因此需要遍历列表,只打印 type 为 text 的内容:
data = response.json()

print("Assistant>", end=" ")

for block in data["content"]:

    if block["type"] == "text":

        print(block["text"], end="")

print()
除了最关键的回答正文,后续还可以分析 Token 消耗量等信息,进行更细粒度的管理。
至此我们完成了一次最简单的LLM调用。恭喜你成功迈出了Agent的第一步!

 yoaning 09-20 08:581楼
 Rainbow-13 09-20 09:002楼
 superjack 09-20 09:003楼
 鱼大王 09-20 09:014楼
 susu 09-20 09:095楼
 ruyi1024 09-20 09:136楼
 errorcode 09-20 09:147楼
 何大帅 09-20 09:458楼
 南山 09-20 10:109楼
 真不错,蹲更。