上次的Strata量化测试,不少人说结论不清晰,太长懒看,这次数据方面直接放进opus生成的artifact,直观很多,结论部分则只看几个大标题就够了
哦我的老天爷,宣传说32g内存+12g显存的电脑上就能跑tmd qwen3.8-flash-next,这strata简直像魔法一样,我真想用我的靴子狠狠地踢只肯给那么点显存的老黄的屁股,哦我一定会的
但总归有些担心,这玩意儿会不会损失太多,还不如直接llama.cpp跑qwen3.8-27B啥的,所以假期最后一天,挂着做了一些测试
^-^
测试环境
测试基线
llama.cpp qwen3.8-fl…
deepseek-v4.1-flash-1017跟qwen-3.8-flash-next的详细量化数据
数据依据的测试环境
依旧是上次那台机器
cpu:9950x3d
ram:ddr5 6400mt 64g(实际测试只用了30g内存)
gpu:5090 32g
ssd:9100pro 8t、p5800x 1.6t
Xolotl(即Strata-deepseek) base commit 281afdada6c221a8757b7b2c2c0e98783afe52c9
以下是根据上面的数据,得出的结论与推测
Strata与llama.cpp存在偏差,EAR偏差幅度相当于一级量化
是的孩子们,我被打脸了
尽管KLD、top-1甚至PPL几乎完全一样,但EAR这个看概率分布的重叠程度的新指标,揭露出了Strata的损失
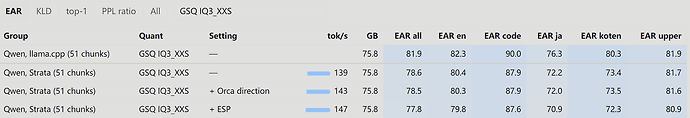
平均差距在2-3%左右,比误差大,从unsloth的估算表来看,相当于IQ3_XS变IQ3_XXS的幅度
什么是EAR
EAR即Expected Acceptance Rate,统计原版跟量化版token的概率分布的重叠程度,在SLQ量化方法中被提出,详见[2605.02404v1] Statistically-Lossless Quantization of Large Language Models
简单而言就是top-1这个东西的扩大版,因为top-1只看这个位置有无翻转,但实际上只在temperature为0的极端条件,才会是全看top-1
比如原版这个位置有两个候选token,0.51跟0.49,量化版变成了0.49跟0.51,top-1直接判为不一致,但这种情况EAR仍有98%
反过来同理,原版0.9跟0.1,量化版0.6跟0.4,top-1仍旧判为一致,但EAR仅剩70%
实际计算起来特别方便,因为只要你能算KLD跟top-1,你就能通过只加一两行代码的方式统计出EAR的值,事实上这次的EAR也是取上次的实测数据,由CPU提取计算出来的
内存影响可能比想象中的小
不知道是不是因为我是同频6400压延迟而不是分频8000冲带宽(是我不想吗,我冲了几次8000都是蓝屏),用来跑模型的内存从30g提高到42g,tps上精确模式也只有个位数的差别,对于light、fast这种让router倾向于选在显存中的专家的加速模式,tps的提升更是高达1%
但vincalkr的a卡报告中,他也不是物理加了一根,同样是通过启动strata时给它多分配一点内存的方式,内存从60g到75g ,速度+40%,挺奇怪的,因为60-75这个量级远达不到所有专家正好能全放内存里的点,如果是跨越了这个点导致速度暴涨,那还能理解,但他不是
可能的原因
opus抓出来,这对ddr5的带宽大约100G/s,但内存->显存的交换带宽,只有50G/s多一点,这是pcie5.0x16硬件上的限制
而p5800x跟9100pro,双ssd跑模型时的实际总带宽,也有近20G/s(是的孩子们,大肥鱼比三角洲扫盘还牛逼),大约在双通道ddr3不超频的水平。在显存、内存、ssd的专家需要发生交换的场景,并没有差出一个量级,而显存则是2000G/s,对于显卡而言,这两个都是一个级别的慢
ssd跟内存唯一差出几个量级的是延迟方面,但我电脑的实测来看,感觉延迟关系不太大,也可能是双ssd存多份专家同步读取的方案压低了延迟的影响
另外有个比较有意思的数据是,有次测得时候,chrome忘关了,开着一大堆网页结合跑模型的30g,内存爆了估计是,此时速度下降了约9%
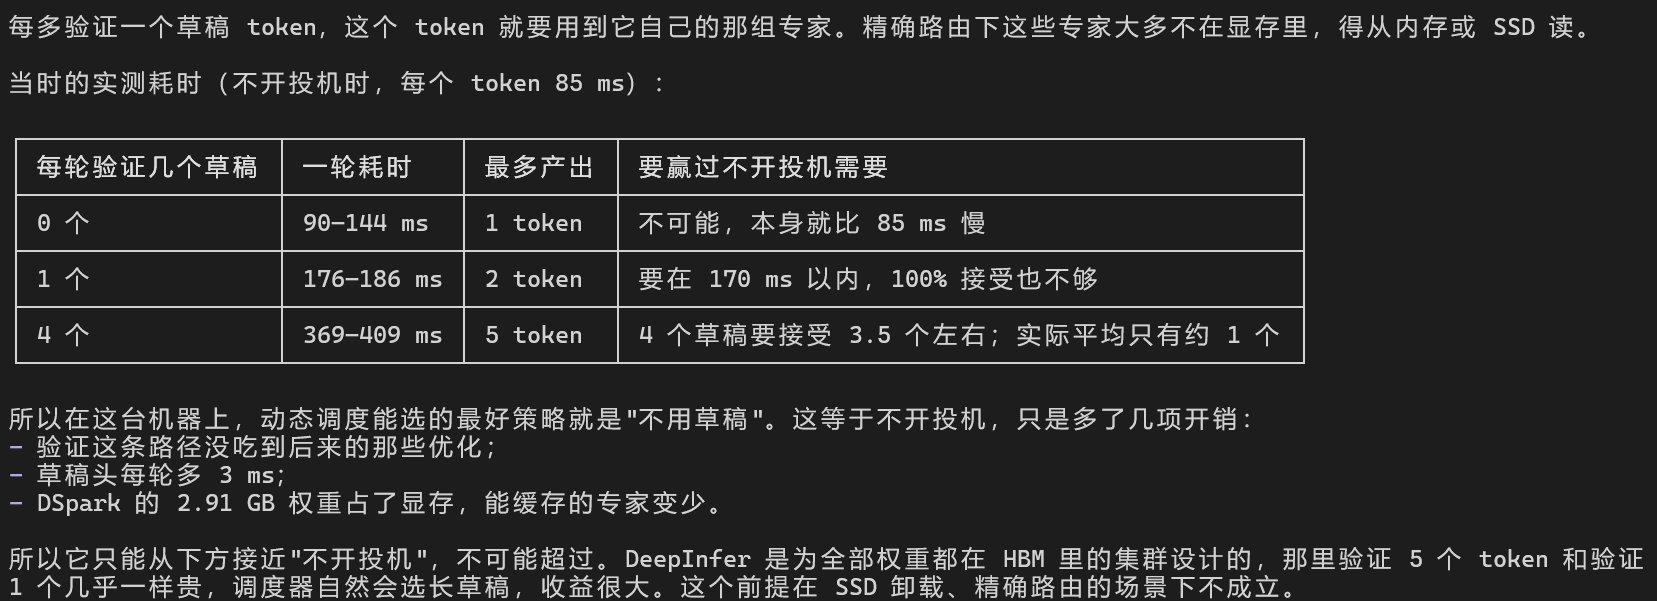
DeepInfer的Dspark动态调度有点东西,但对个人电脑而言可能还不如不开投机
按照不开Dspark跟MTP->Strata固定阈值0.6->让opus cherry pick进来的deepinfer的dspark动态调度的顺序进行了测量
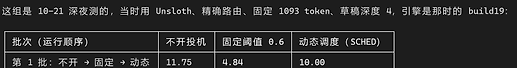
可以看到deepinfer的草稿性能约是固定阈值的翻倍,比较神奇的是我的电脑不开任何投机反而取得了最高的性能,不知道是接受率还是啥问题还是strata对于mtp的支持不太好
opus解释的原因
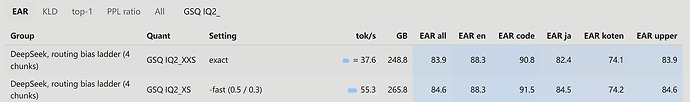
80%以上的EAR或许算是量化版本的高可用线?据此ds-v4.1-flash-1017推荐使用GSQ IQ2_XS开fast
这条主要是根据qwen-3.8-flash-next的情况推测的,qwen的GSQ IQ3_S大约在80%EAR左右,而该量化的各类benchmark,推上的Benjamin Marie测了许多,也包括实际agent中的测试,可以认为qwen-3.8-flash-next的GSQ IQ3_S是极其接近原版的
而deepseek对于量化的耐性看上去比qwen强得多,可能受益于架构的改进或者是fp4还是8训练的来着,量化都2bit了,各项量化指标还是挺好,梁子有点东西的
在IQ2_XS的fast下,不管是EAR还是PPL、top-1等,都是跟IQ2_XXS极其接近的,但速度上了一个台阶
一些比较大的优化
以上三项总计提升接近40%的速度
- 显存余量从1g放大到2g,即只用30g存模型等一堆负载,不然实际会存在显存溢出到内存里严重拖慢,
可能也是因为我桌面也是这张卡画的,需要多留一些空间
- 每个要读的专家都拆成多份,多盘多线程读
- 预取时不再给猜测的专家专门传全0占位符,不然也占带宽
以上三项总计提升55%的速度
以及一堆比较针对性的优化,挺绑定我电脑的情况的,不太适合合代码,可以让ai参考着改,加的优化默认都是关闭状态,记得让ai部署的时候记得带上,xolotl-rebase-281afdad.zip (64.3 KB)
Xolotl本身带有的有损优化加了light跟max的多个档位,就是上面提的fast啥的,原理是给已经在显存里的专家加分,给需要从 SSD 读的专家减分,让路由尽量挑现成的专家,从而少读盘。提升速度的效果很显著,只不过存在边际效应,基本light这种轻微倾向就能获得大部分性能了
碎碎念
这次session的全程,还是第一次见到干活这么卖力的claude,明明之前strata部署qwen的时候爱搭不理的,动都懒得动,纯是strata裸跑,不知道为什么到了大肥鱼就像是发狠了忘情了前前后后提了50多个优化点,全链路抓数据详细分析,甚至提议超频跟加内存。。。是我不想加吗?这内存价格谁下得去手啊,大肥鱼,是这乱世害了你啊
不知道你们懂不懂,就那种,gpt 5.5刚出的那种卖力感,平时最近的opus5.5明明只有gpt 5.5末期那种说一句动一下流口水的感觉
昨晚甚至ip不小心从横滨跳到东京,直接触发重新登陆风控,但今天都还没封,感觉claude真会检测用户对话质量吧?
总不能是因为喜欢大肥鱼要给她一个完整的人生吧

 approachai 10-26 12:181楼
 Light 10-26 12:292楼
 𝕹𝖔𝖙𝖍𝖎𝖓𝖌 𝖎𝖘 𝕿𝖗𝖚𝖊. 𝕰𝖛𝖊𝖗𝖞𝖙𝖍𝖎𝖓𝖌 𝖎𝖘 𝖕𝖊𝖗𝖒𝖎𝖙𝖙𝖊𝖉. 10-26 12:395楼
 FFattiger 10-26 12:417楼
 柏川 10-26 12:459楼