没想到测试Codex和GPT降智的好方法竟然是我提出的问题

三点水也 2026-06-23 14:12 1

[!abstract]

最近很多佬友都发现 GPT 5.5 存在降智的情况,有热心佬友写了测试是否降智的脚本,我认真一看,发现测试题目竟然是我当初提出的问题,心里挺高兴,总算是为社区做了点贡献。


原始题目在这里


这道题很有意思,看似很难,其实我想大部分佬友多读几遍题,慢慢推理,应该都能做出来。

但是为什么很多大模型都会做错呢?我认为是因为这道题有一点反常规,大模型如果按照训练材料来做题,必错。


[!bug]

模型必须靠自己推理才能做对。


所以这道题用来测试模型是否降智非常合适。


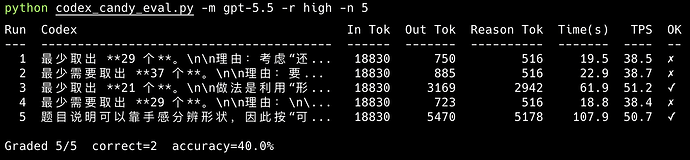
可以看到,做对的情况就是推理token比较大。做错就是被降智到推理token是516的情况。


测试脚本在这里

最新回复 (11)
  • Jimm 06-23 14:18
    1

    小白问一下, 模型降智,是账号级别?会话级别?还是整个产品级别?

  • 三点水也 楼主 06-23 14:25
    2

    通常是会话级别的,有的重复测试几次,有时会降智

  • DanicaStar ~ 06-23 14:28
    3


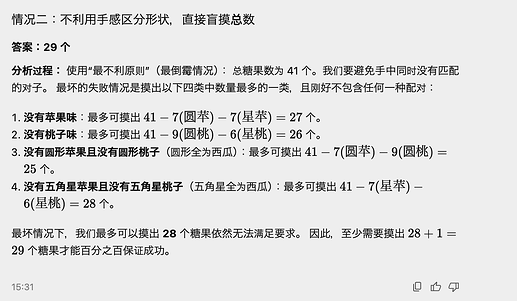
    居然没有降智 可以 很幸运 再试一次降智了,回答29

  • Hifumi Mizuhara 06-23 14:32
    4


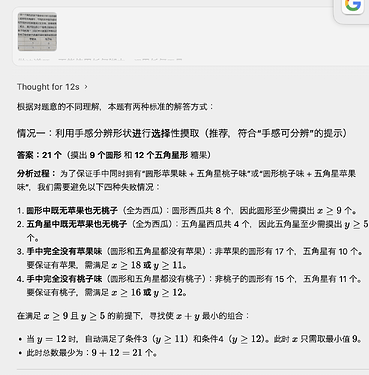
    用哈基米也试了试,怎么还分类讨论上了


    用了12s ^-^


    所以答案是21才是对的对吧

  • haowang 06-23 14:48
    5

    哇,大佬本佬。


    这道测试题的确是我很早的时候在L站复制的。当时就发现这道题刚好能区分gpt-5.5/gpt-5.4降智和不降智,并且题目的答案是唯一的,方便通过脚本直接判断是否回答正确。所以在写codex测试脚本的时候用了这个题。


    要找一道合适的测试题很难,感谢大佬。

  • haowang 06-23 14:51
    6

    我用这道题测试过很多模型,包括大部分国产模型,国产模型基本上只能回答出29这个短路错误答案,DeepSeek V4 Pro开max思考强度的时候有机会答出21,但是思考时间非常长。

  • shiying 06-23 14:53
    7

    感觉是题目写的太绕了…看了半天我自己都没看懂想要干嘛…

    不过确实看懂之后就是21很简单


    拿ds试了一下也是29,感觉对模型来说还真的挺陷阱的,那个可以凭手感确定的条件很重要,但ai看起来估计就是那种核心题干外的普通信息没管,只看最少然后找最坏条件去了

  • 三点水也 楼主 06-23 15:04
    8

    是的,模型如果按照常规思路去做就会做错,所以说必须模型自己推理思考。

  • 你好❤️ 06-23 17:14
    9

    Claude opus 4.8 max,试了三次,都是29 ^-^

    换成了opus4.6 high直接就答对了,无语。。。。。

  • 李知恩 06-23 17:34
    10

    哈吉咪确实会出两个方案, 但是12秒有点太快了吧,是不是搜答案了

  • Hifumi Mizuhara 06-23 17:34
    11

    没,我看着,没有任何搜索调用


    Antigravity里面的,没调用任何工具

* 帖子来源Linux.do
返回