万元本地跑GLM5.2,佬友们快来打醒我。

YaoEIF 2026-06-27 15:37 1
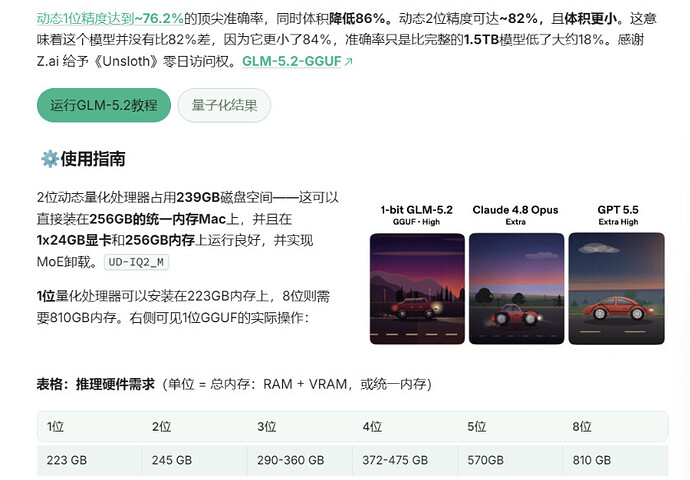
Unsloth GLM-5.2


1位精度能有原模型的约76.2%的能力

2位精度能有原模型的约82%的能力


也就损失了约18%,但是能在一个24G显卡和256G内存上部署了。


我是这样想的,与其抢哪个怎么也抢不到的GLM Coding Plan,不如组个洋垃圾平台再整个魔改的V100或者3090。


配件 规格 单价 数量 小计
内存 DDR3 32GB 180元 ×12 2160元
平台 浪潮M2216 + 双E5 + 电源 + 配件 — — ≤1500元
GPU V100(鱼上买改好的) — — 3750元
硬盘 自备 — — 0元

这样总计 384GB 内存 32GB 显存,说不定能跑2精度

虽然能预想到不光模型加载慢,推理慢,上下文也难说。

不过万元以下本地跑 GLM5.2(量化版)


嘿嘿^-^,想想就流口水


想问问有没有佬友实践过,

最新回复 (19)
  • P01 06-27 15:38
    1楼

    买DeepSeek是不是能用一辈子

  • WWT 06-27 15:38
    2楼

    不是,这预算怎么越来越抠了

    上次还是20万,然后2万 这回直接到万元了^-^

    虽然不是同一个佬^-^

  • 十元 06-27 15:38
    3楼

    这种级别的参数大模型真的跑得动吗

  • 林语尘 06-27 15:38
    4楼

    说实话,你拿这钱搞模型不如去按摩洗脚了


    好歹人工大模型^-^

  • JohnDIck 06-27 15:39
    5楼

    现在内存太贵了,ddr5ddr4太贵,ddr3太慢

  • 太阳之子 06-27 15:39
    6楼

    刚才看到了,比早年哪吒2的压片大战还狠(不懂什么是哪吒2压片大战的可以百度下)

  • wjy 06-27 15:39
    7楼

    这个吐字速度和上下文长度,真的能用吗,用来干什么啊

  • YaoEIF 楼主 06-27 15:40
    8楼

    deepseek v4 pro 开MAX思考强度,让他抄个前端,把mhtl给他(无技能/一句prompt直出),结果抄的一坨。glm5.2 基本完全还原。

  • SamWang 06-27 15:40
    9楼

    输入输出同样的 token 数,电费会比直接官网买用量的便宜吗?

  • Autsun 06-27 15:41
    10楼

    DDR3内存跑会很慢,而且电费可能比codingplan更贵

  • YaoEIF 楼主 06-27 15:42
    11楼

    薅公司的电 ^-^ 这不相当于白嫖了

  • JohnDIck 06-27 15:42
    12楼

    之前有人出过魔改v100的方案,把32g的吹下来放到新的板子上还加了8卡的nvlink,不知道是不是ppt产品。真想搞得话8卡v100应该是性价比方案

  • 林语尘 06-27 15:43
    13楼

    你都这么说了,还要我们劝你干嘛呢?

    你直接上吧,反正 万把块钱也不多


    追求自己热爱的东西挺好的


    记得回来分享一下使用体验

  • ak7876 06-27 15:43
    14楼

    ddr3别想了,我是在公司e5配ddr3,32g。当时ollama安了个什么12b还是多少来着,反正是给十几b的模型。吐字速度高达2-3字每秒。你要是忍得住可以搞,然后同情况,一个7b的在我的macminim4上跑,起码每秒二三十字,着起码是能用了。每秒2-3字着啥玩意

  • 星夜大哥 06-27 15:44
    15楼

    上闲鱼花50块找人代抢,抢一年的套餐也就4500多。一年后,说不定AI都发展成什么样了,你的那套配置能不能带的动了。


    还有,电费你也要考虑一下,你那套配置,一个月电费都得百来块钱吧,还不是24小时一直运行的那种

  • Autsun 06-27 15:44
    16楼

    是的,与其用内存,不如多买几张显卡,不然速度很慢,基本上没有可用性

  • Firefox 06-27 15:45
    17楼

    ddr3别想了,我是在公司e5配ddr3


    估计没法用的状态


    等着楼主跑完太卡然后卖二手设备了 ^-^

  • Autsun 06-27 15:47
    18楼

    我在公司测试过5090和3090跑ai,跑的qwen3.6 35B A3B的模型,5090上面,35BA3B用Q4量化,可以达到230+t/s的速度,gemma 4 26BA4B的Q4量化在3090上可以到150+t/s的速度,如果卸载到内存上,速度会慢特别多,忘记是多少了

  • 人间清醒指南 06-27 15:48
    19楼

    勉强能架起来, 但是基本没速度。 精度也不行。 至少要 FP4量化。 上下文还特别消耗显存。 1M上下文还要20G左右显存。 FP2,FP4, 这个老GPU还不支持优化。 非常非常慢。 要本地跑 要本地跑至少要 Mac Studio M3 Ultra 512G (二手13W). 大概也顶多 跑 FP4量化, 实际 5tokens/s 512k上下文同时能两个一起。 理论上得等到明年年底的 DXG Spark 2代 4个互联来跑。 没30万搞不定。 其他方案更贵,更不可能家用

* 帖子来源Linux.do
返回