【开源推广】前辈基础上又搓了个Cursor反代,理论上不会被封

Non-user 2026-09-20 14:46 1
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:


  • 我的帖子已经打上 开源推广 标签:

  • 我的开源项目完整开源,无未开源部分:

  • 我的开源项目已链接认可 LINUX DO 社区:

  • 我帖子内的项目介绍,AI生成、润色内容部分已截图发出:

  • 以上选择我承诺是永久有效的,接受社区和佬友监督:


以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出


项目地址


^-^ GitHub:iFwu/cursor2response


为什么做这个?


Cursor SDK 开放了接入 Cursor 云端 Harness Loop 的接口,但目前很少有项目把它包装成丝滑顺手、支持长程 Agent 使用的 API 网关。


之前看到佬友 [开源推广]自己搓的一个cursor2api反代项目 这个项目。但在实际接入 Codex 和 OpenClaw 后,在写代码/Agent任务等高频工具调用和用户追问场景下才发现:原方案在 SDK 侧几乎每次工具调用都会开一个新的 Run。不仅吃不到 SDK 内部的 Prompt Cache,长任务消耗巨大,上下文还可能因为太大导致截断或者遗忘。


做了哪些重构


在这基础上,我大幅重写了状态机和核心架构,把协议适配收敛到 Responses API,解决了以下痛点:


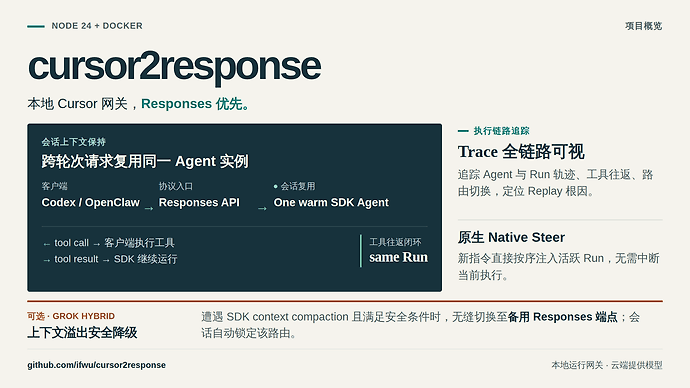
  • SDK Run 复用:同一个会话中,只启动一个 Cursor Agent,常驻跨轮复用。工具往返都在一个 Run 里吞吐,吃满 SDK 内部缓存,大幅减少冷启动 Token 消耗和延迟

  • 原生 Steer 支持:支持在模型执行工具调用后直接插入用户指令,无需中断或者重启任务(Codex 和 OpenClaw 均支持)

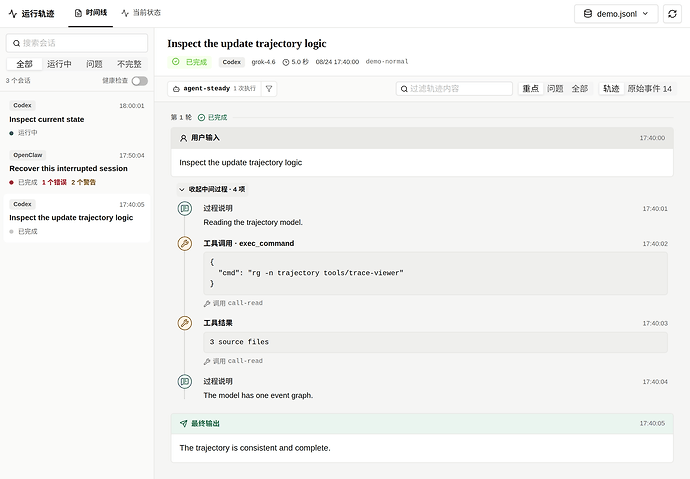
  • 自带本地 Trace Viewer:搓了一个可视化 Web Trace 面板,可查看 Agent 轨迹、跟踪会话分叉点、工具调用参数、SDK 缓存状态等信息(见图二)

  • 上下文溢出降级:如果上下文已经超出 SDK 所支持的长度,Cursor 内部触发压缩,可自动切换到备用 Responses API,会话不丢失上下文(需要配置备用 API 接口,最好是同一个模型。项目不使用 SDK 自带压缩,由 Agent 接入方压缩)

  • Docker 一键启动:支持 Docker Compose 一键拉起服务,也支持 Node 24 直接运行


其他使用可以参考 GitHub 的 README,有什么问题也可以回复,会尽可能帮助到大家。


:关于是否会封号风险,没有谁能打保票。结合 Cursor 官方论坛里的工作人员回复,合理使用 Cursor Web 设置中生成的 API Key,个人用于 Agent 项目集成,应该是没问题的。如果有什么情况大家也可以留言交流。


最新回复 (4)
  • 小飞侠 09-20 17:14
    1

    是不是可以加个网络代理设置功能, 正常cursor的api请求不能国内直连吧, 直接全局tun感觉不是很好

  • Kotori 09-20 17:22
    2

    其实pi 就有一个用 cursor-sdk 的东西,可以在pi里调用 cursor 的模型,原理应该差不多

  • Non-user 楼主 09-20 18:09
    3

    对,应该是 pi-cursor-sdk。这个我们之前横向调研 @cursor/sdk 生态时看过,有一些启发吧。


    不过它的定位是 Pi 的扩展:它把 Cursor Agent Loop 接进 Pi,Pi 会处理模型选择、session、tool bridge 等等。这个项目是独立的 Responses HTTP gateway,希望让 Codex、OpenClaw 等不同客户端都能接入。

  • Non-user 楼主 09-20 18:28
    4

    可以,补好了,支持标准的 Node 代理环境变量。如果代理不支持 HTTP2,还可以开启 CURSOR_SDK_USE_HTTP1_FOR_AGENT=1,切换到 HTTP/1.1 + SSE。


    Docker 下需要注意,宿主机代理必须能从容器访问,不能直接填只监听在宿主机 127.0.0.1 的地址。目前支持 HTTP(S) proxy,暂不支持 SOCKS。


* 帖子来源Linux.do
返回